Why VPU

VPU ネイティブ・インフラストラクチャー

専用設計のプロセッサが、
標準になる時代へ。

製品の優劣を比べる話ではなく
移行負荷を最小限にしながら
運用コストを抑える話です

今、動画配信の現場を圧迫しているのは「何ができるか」ではなく「それを続けるのに、いくらかかるか」です。

同時接続数は視聴者数の伸び以上のペースで増え続け、ABR(適応ビットレート)のラダーは、エンコード効率の改善スピードを追い越しています。消費電力、処理密度、そして「予測できること」が、いまや処理能力そのものと同じくらい重要になっています。

同じ 1 本の動画を処理するのに、必要な電力はこれだけ違います。

CPU

あらゆる処理を汎用的にこなす代わりに、動画はすべてソフトウェアで処理

動画処理に使われる割合

0 %

(専用回路なし)
= 約 9.4 W

1 ストリームあたりの消費電力

GPU

グラフィックス・AI 処理が主目的で、動画処理に使えるのは一部のみ

動画処理に使われる割合

約 15 %

(小さな固定ブロック)
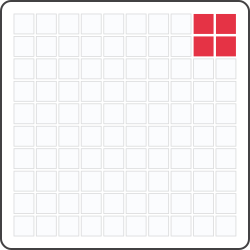
= 約 3 W

1 ストリームあたりの消費電力

エンコード・デコード・スケーリングのすべてを動画処理専用に設計

動画処理に使われる割合

(チップ全体)

= 約 1.56 W

1 ストリームあたりの消費電力

※本数値は、システム全体の総消費電力を、持続的な 1080p30 エンコード処理能力(ストリーム数)で割った値に基づきます。実際の測定結果は、システム構成や運用環境により異なる場合があります。

映像インフラの評価軸は、もはや「何ができるか」ではありません。

—— この 3 つで測られる時代です。

VPU は、そのいずれにおいても、最も低コストな選択肢になります。

CPU 性能の伸びは年 5 〜 10 %
コーデックの複雑さは、その間に 100 倍以上に
CPU の処理性能は、年間 5 〜 10 % 程度の伸びにとどまっています。一方でコーデックの複雑さは、この数年で 2 桁(100 倍以上)増加しました。この差は、ソフトウェア側の工夫だけではもう埋まりません。AV1 のような先進コーデックを大規模に扱うには、専用設計のシリコンが唯一、現実的な選択肢です。

FAQ

プラットフォームエンジニアの方向け

VPU とは何ですか?

VPU(Video Processing Unit)は、チップ全体を動画エンコード処理に使う専用チップです。CPU は動画処理専用の回路を持たず(0 %)、GPU はグラフィックス・AI 処理が主目的のため、動画処理に使えるのはおおよそ 15 % 程度です。VPU がワットあたりでより多くのストリームを処理できるのは、この設計の違いによるものです。

FFmpeg や GStreamer と組み合わせて使えますか?

はい。NETINT の VPU は、標準的な FFmpeg・GStreamer のインターフェース、および直接連携向けの libxcoder API で動作します。専用 SDK へのロックインはありません。映像のパッケージング・配信の仕組みはそのまま使えて、変わるのはエンコード処理の部分だけです。

対応しているコーデックは?

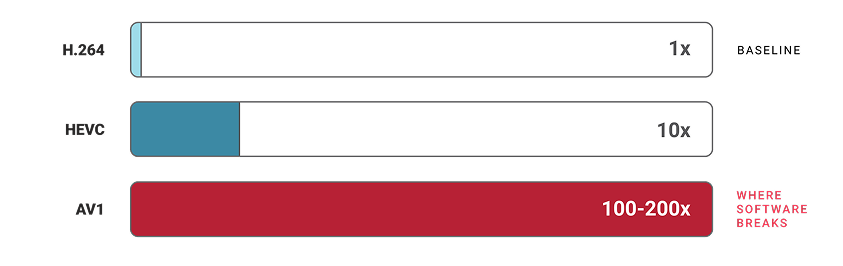
AV1・HEVC・H.264 を 8bit / 10bit で、8K 解像度までハードウェアエンコードに対応しています(デコードは VP9 にも対応)。中でも AV1 が重要です。H.264 と比べて 100 〜 200 倍の演算負荷があり、ソフトウェアエンコードではもはやコスト面で成立しない領域に入っています。

画質はソフトウェアエンコードと比べてどうですか?

実際の本番環境で使う設定同士で比較してください(誰も使わないベンチマーク用の設定ではなく)。本番相当の速度設定・同一ビットレートで比較した場合、遜色ない画質が得られます。私たちの説明を鵜呑みにせず、パイロット導入の中で、御社自身のコンテンツで検証いただくことをおすすめします。

ハードウェアを購入せずに評価する方法はありますか?

クラウド上で、費用をかけずに始められます。エコシステムパートナーのクラウドが VPU のパイロット導入を後押ししており、Akamai Cloud は新規アカウント向けに 30 日間のパイロットへ 500 ドル分のクレジットを提供、NetActuate も対象チーム向けに無償の実証実験(PoC)を実施しています。ハードウェア購入の判断をする前に、ご自身のワークロードでアーキテクチャを検証できます。

運用ご担当の方向け

VPU サーバー 1 台で、何本のストリームを処理できますか?

NETINT Quadra Video Server は、1080p30 換算で 320 本、4Kp30 で 80 本、8Kp30 で 20 本を同時処理できます。同じラックスペースの CPU ベースのエンコードサーバーと比べて、おおよそ 40 倍の処理能力に相当します。

実務上の「確定的な処理能力」とは、どういう意味ですか?

各 VPU には、固定かつ既知の処理能力があります。導入初日に 320 本処理できるカードは、10,000 時間稼働した後も変わらず 320 本処理できます。弾力的な余力を見込んで概算するのではなく、確定した本数をもとに調達・施設拡張・人員計画を立てられます。

VPU 導入のために、新しいサーバーが必要になりますか?

いいえ。VPU は PCIe または U.2 カードとして、すでにお持ちのサーバー(用途を終えたシャーシも含む)にそのまま組み込めます。パートナーのクラウド上で VPU インスタンスを動かすことも、両方を組み合わせることも可能です。導入形態は選びません。

導入時のリスクをどう考えればよいですか?

移行は並行運用で進みます。既存のエンコード環境と同じコンテンツに対して VPU エンコードを走らせ、結果とコストを比較しながら進められます。切り替えは、御社自身のデータが判断材料になったときにのみ行い、各段階は元に戻すことができます。目安として、検証(Explore)に 1 〜 2 週間、テストに 2 〜 4 週間、移行に 4 〜 8 週間ほどです。

ハードウェアを購入せずに評価する方法はありますか?

クラウド上で、費用をかけずに始められます。エコシステムパートナーのクラウドが VPU のパイロット導入を後押ししており、Akamai Cloud は新規アカウント向けに 30 日間のパイロットへ 500 ドル分のクレジットを提供、NetActuate も対象チーム向けに無償の実証実験(PoC)を実施しています。ハードウェア購入の判断をする前に、ご自身のワークロードでアーキテクチャを検証できます。

消費電力や冷却への影響は?

カード単体で計測すると、Quadra T1A はフルロード時 20 W で 1080p30 ストリームを 32 本同時処理します。VPU 単体では 1 ストリームあたり 0.63 W です。システム全体(壁面計測)で見ると、フルロードの 1RU Quadra Video Server は約 500 W で 320 ストリームを処理しており、システム全体では 1 ストリームあたり約 1.56 W となります。いずれも実測値です。

経営・財務判断をされる方向け

VPU 導入で、コストはどれくらい下がりますか?

汎用サーバー上のソフトウェアエンコードと比較して、1 ストリームあたりのエンコードコストは 60 〜 80 % 削減されます。しかもこの効果は規模が大きくなるほど効いてきます。同時接続数が増えても 1 ストリームあたりのコストは横ばいのままですが、汎用サーバーの場合はコストが右肩上がりになっていきます。

なぜ今、この判断が必要なのですか?

3 つの変化が重なったためです。AV1 の登場でコーデックの複雑さは 100 倍に増加しました。CPU の性能向上は年 5 〜 10 % にとどまっています。そして特に欧州では、エネルギー関連の規制が「1 ストリームあたりの消費電力」に対するコンプライアンス期限を設け始めています。様子見をしても、このどれも止まりません。

設備投資(Capex)と運用費(Opex)、どちらの扱いになりますか?

どちらにもなり得ます。自社または既存のシャーシに組み込む VPU カードは設備投資、パートナークラウド上の VPU インスタンスは運用費です。多くの企業が両方を組み合わせるハイブリッド運用を選んでいます。効率化の源泉は「どう導入するか」ではなく「シリコンの設計そのもの」にあるため、どのモデルでも経済合理性は成立します。

自社で Google や Meta のような専用チップを開発すべきではないですか?

Google や Meta(の Argos、MSVP)は、数十年単位の設備投資をかけて自社専用のエンコード ASIC を開発しましたが、いずれも外部への販売はしていません。VPU は、オープンな市場に同じアーキテクチャを届けるための手段です。公正に競争するすべてのプラットフォームが、自社開発をせずに同じ設計思想を導入できます。

効果が出るまで、どれくらいの期間が必要ですか?

1 〜 2 週間です。パイロット導入では御社の実際のワークロードを使って検証するため、得られる数字(1 ストリームあたりのコスト・消費電力、ラックあたりの処理本数)はすべて御社自身のデータになります。投資判断の根拠は、私たちの主張ではなく、御社のデータから組み立てられます。